

以前开会,最怕的是录音没录下来。
现在设备越来越好了,录音质量提高了,自动转写也越来越普遍,但新的问题出现了:
录音明明很清楚,为什么最后整理出来的会议内容还是会错?
原因其实不复杂。
因为“录得清楚”和“理解正确”是两件事情。
01 录音清楚,不代表每句话都容易识别
会议室里经常出现这样的情况:
一个人讲话,另外一个人在翻资料,旁边有人敲键盘,空调一直在响。
这些声音录音设备全部都会收进去。
人耳可以根据经验判断哪些是背景声音,但机器需要经过处理才能区分。
所以一套完整的语音系统,通常不是:

而更像:

其中任何一个环节出现问题,最后的文字都可能受到影响。
02 最麻烦的其实是多人讲话
一个人说话,系统只需要判断“他说了什么”。
会议里三个人连续说话,就开始复杂起来。
例如:
A:这个项目本周能不能上线?
B:测试还差两个模块。
C:那就先把风险项整理出来。
如果系统不知道谁在说什么,最后得到的只是三句话。
但会议真正需要的,是:
A:提出上线问题B:反馈测试进度C:提出下一步行动
这也是声纹相关技术在会议场景中的价值。
它解决的不只是“声音是谁”,而是让后续的会议整理拥有了人物维度。
03 为什么离线会议越来越受到关注?
这几年很多人开始关注一个问题:
会议录音一定要上传服务器吗?
其实不一定。
如果设备本身有足够的算力,可以把部分语音处理放在本地。
例如:
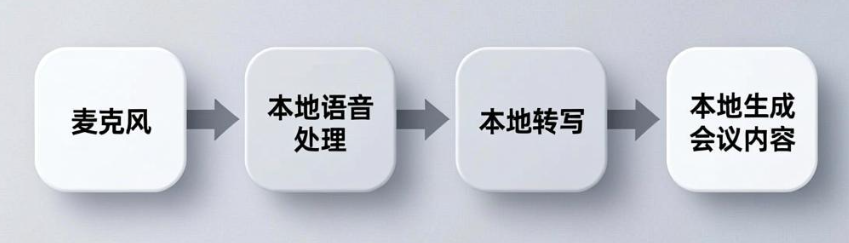
对于企业内部会议、政务会议、研发讨论来说,这种方式最大的意义不是“听起来高级”。
而是减少敏感音频离开本地环境的需求。
当然,本地运行并不等于自动完成安全管理。
账号权限、日志、存储策略仍然需要做好。
04 端侧设备还有一个现实问题
设备不是服务器。
服务器可以加机器,端侧设备通常只能在有限的 CPU、内存和电池条件下运行。
所以一个真正适合端侧的模型,需要在几个方面取得平衡:

如果只追求准确率,模型越来越大,最终设备可能跑不动。
如果只追求速度,又可能牺牲识别效果。
所以现在看端侧语音,我更愿意把它看成一种工程能力。
05 我最近比较关注的一类产品
包括熙瑾会悟这类离线会议方案,我觉得真正值得观察的不是宣传页上的一句“智能会议”。
而是把设备拿到真实会议室以后:
- 远处的人能不能听清?
- 空调声下是否稳定?
- 多人讲话会不会混?
- 一小时以后会不会变慢?
- 数据是否需要上传?
这些问题,比单纯看一个识别率数字更有意义。
最后
语音转写技术已经越来越成熟。
但从“把声音变成文字”,到“真正理解一场会议”,中间其实还有很长一段路。
未来的会议设备可能不会只是一个录音工具。
它应该知道什么时候该听、谁在说、说了什么,以及哪些内容真正值得留下。
这才是智能会议真正有价值的地方。





热门跟贴