
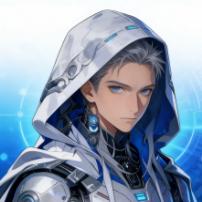
给一句需求,它自己造出一个角色,然后把这个角色一路用到片尾。Muse 在人物一致性上的表现,被评价为"已经达到较高的水平"。
这条来自 PixelAIGC 的分享,核心不是画面有多好看,而是角色没有在镜头切换时"变脸"。生成一段 60 秒的视频,跨越多个场景,主角始终是同一个人——这件事在 AI 视频里一直不好办。
它先给自己造了一张"角色卡"
Muse 的工作流是这样的:接到需求后,它先自主生成一个统一的角色资产卡,相当于给这个角色定妆。之后的每一个片段,都回头引用这张卡,再拼接成完整叙事。
这个顺序很关键。不是先生成片段再想办法统一人物,而是先把人物的"身份"固定下来,再让各个场景去适配它。场景可以换,人物的身份锚点不动。
素材里提到的效果是:片段之间的过渡自然,叙事保持连贯。换句话说,观众看到的不是几段拼起来的素材,而是一个从头讲到尾的故事。
被拿来测试的是一首宋词
这次生成任务的对象,是秦观的宋词《点绛唇》。Muse 把它转译成了一段 60 秒的视频。
选宋词做测试,难度其实不低。词这种体裁本身就有场景转换和情绪流动,从一句到下一句,画面往往要换地方、换时间、换氛围。人物如果在这个过程中走形,整段视频的叙事就断了。
60 秒不算长,但要在这 60 秒里保持同一个人物、完成多次场景切换、还要让转场不生硬,考验的是模型对"身份"这件事的持续记忆能力。
一致性为什么是道坎
AI 视频生成里,单帧好看不难,难的是跨帧稳定。同一个角色出现在第二个镜头里,脸型、发型、服装细节稍有漂移,观众立刻出戏。
Muse 的做法是把角色抽成一个可复用的资产,而不是每次重新"想象"这个人。这个思路把问题从"每一帧都要猜对"变成了"每一帧都去对齐同一个参照"。
素材给出的判断是,Muse 在人物一致性上已经达到较高水平。这个评价对应的具体表现,就是那段 60 秒视频里的无缝转场和叙事连贯。
从产品角度看,这条路径指向的需求很明确:当创作者想讲一个有主角的故事,而不是生成一堆互不相干的漂亮画面时,角色能不能"记住自己是谁",决定了 AI 视频能不能真正进入叙事场景。




热门跟贴