

大模型动辄几千上万张GPU一起跑,芯片之间不停交换数据。现在靠电信号走铜线,距离一长、速度一快,信号就衰减;为保信号只能猛加功耗。有测算说,AI集群不少电不是用来算,而是用来搬数据。
业界转向光:损耗低、带宽大、发热少。但光模块不能离芯片太远,否则电信号先损耗大半。于是方向变成把光引擎搬到芯片旁,甚至和芯片封装在一起,叫共封装光学。问题也来了:芯片边寸土寸金,光纤接口不能多。办法是波分复用——一根光纤划出多条“车道”,不同颜色的光各跑各的。
传统做法每多一个通道,就多一个激光器。8通道就是8个激光器,功耗、体积、成本全涨,还要逐个稳频。
中国团队换了材料:薄膜钽酸锂。电场一加,光就跟着变,编码极快;双折射低,做波分复用的“分车道”特别顺手。铌酸锂调制也快,但双折射高,容易串道,要额外补偿。
他们在5×15毫米芯片上,把“拆成8条—各自加载数据—再合回一根”集成到一起。输入一根,输出一根,中间8条独立干活。
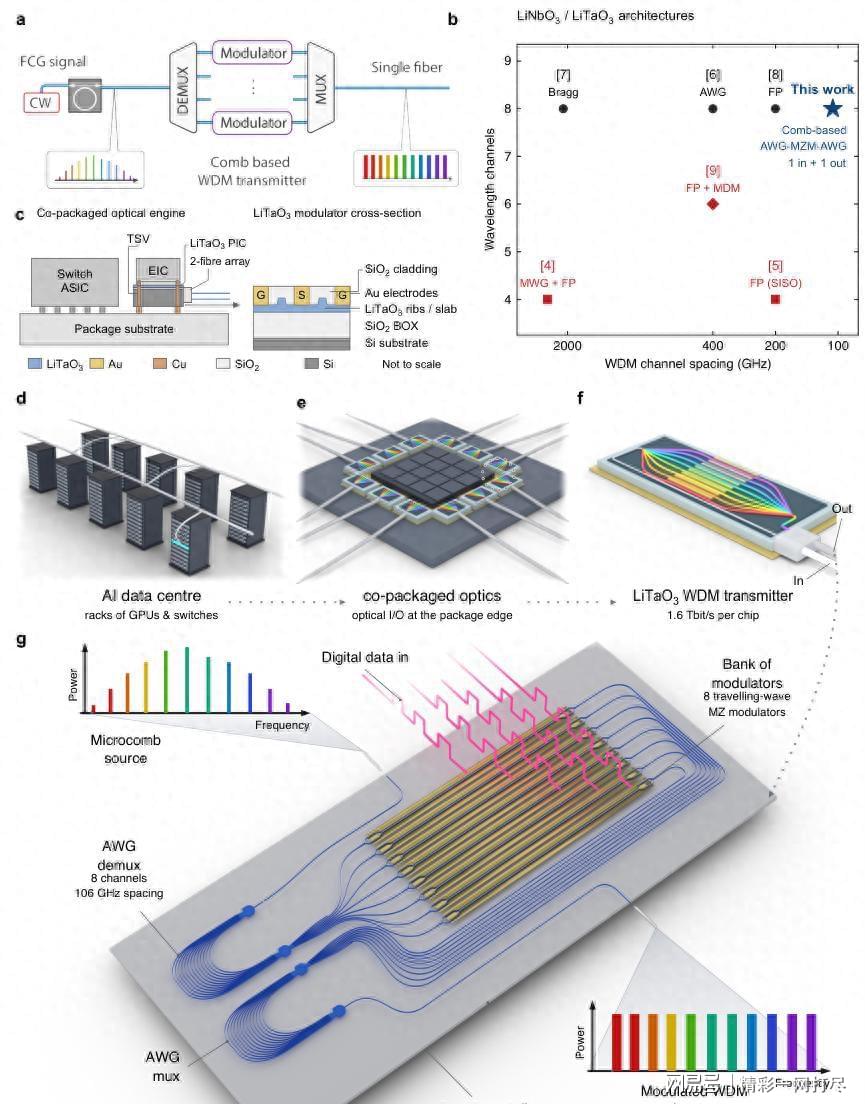
AI算力互联已是全球最激烈的科技战场之一。美国英特尔、Ayar Labs、Lightmatter等猛攻硅光和共封装光学;欧洲IMEC用硅光平台托起一批公司;日本器件材料有老底子,但新一代薄膜平台动作偏慢。
核心是材料平台。硅光成本低、能借CMOS产线,可硅没有泡克尔斯效应,调制得靠注电子,效率和损耗难两全。薄膜铌酸锂性能好,但加工难、双折射麻烦。薄膜钽酸锂成了第三条路:性能接近铌酸锂,双折射低一个数量级,大规模集成更省心。
材料端,中科院上海微系统所做了晶圆级制备开拓,把薄膜钽酸锂从“实验室切小块”推到“整片晶圆长出来”。器件端,华东师大、华中科大、上海微系统所等在调制器、波分复用、频率梳上持续产出。

未来AI芯片可能不再“计算芯片外插光模块”,而是计算和光互联封装在一起,光引擎贴着芯片,电信号只走毫米级。谁掌握高性能、可制造、封装友好的光引擎平台,谁就多一分底层话语权。
薄膜钽酸锂不是唯一答案。硅光、铌酸锂都在跑。多条路线并进,对中国不是坏事:材料、器件、封装,我们都有牌可打。
一根光纤跑1.6T,今天是大新闻;过几年回头看,它可能只是下一代算力集群的一块“标准砖”。
— 感谢阅读 · 欢迎点赞关注 · 小编 —





热门跟贴