


据投融湾获悉,近日,上海模思智能科技有限公司(下文简称:模思智能)成功完成超10亿元Pre-A轮融资。本轮融资由华控基金领投,主要投资方包括国开科创、上海科创基金、新微资本、徐汇资本、追光硬科技创投、临港策源基金等,元禾控股、上海国投旗下上海科创集团、星连资本等老股东持续投资。本轮融资资金将主要用于推进全模态实时交互智能的研发与能力建设,以及全球商业化落地。
模思智能创立于2024年11月,公司总部位于上海市徐汇区。模思智能的核心定位是,让AI真正"走出屏幕",进入真实世界,做"全模态实时交互智能"。过去几轮大模型竞争,解决的是"AI在对话框里回答问题、写代码、生成内容"——也就是在屏幕里工作。而模思智能要做的是,让AI具备"情境智能",即能持续地看见、听见和理解正在发生的现场——谁在场、之前发生了什么、现在是什么环境、人在做什么、接下来可能做什么——并在不断变化的上下文里,及时给出反馈或行动,从一次性的"输入—输出"走向"持续在场"。
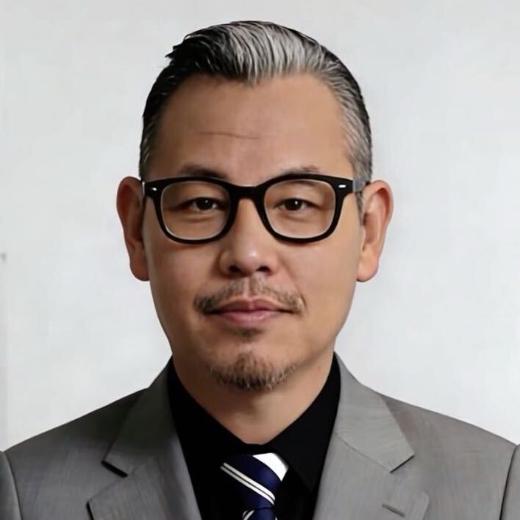
创始人邱锡鹏
模思智能的创始人是邱锡鹏,1997年考入复旦大学攻读学士学位,2001年毕业后继续在复旦攻读博士学位,2006年博士毕业后留校任教,现为复旦大学计算机科学技术学院教授、博士生导师。邱锡鹏长期从事自然语言处理与大模型研究,是国内NLP领域最具影响力的学者之一,多次入选全球前2%顶尖科学家榜单。2024年,创立模思智能,是公司技术路线与学术声誉的源头。
一系列MOSS家族的模型
模思智能的核心产品是一系列MOSS家族的模型,覆盖语音、音频、视觉、视频等多模态能力。
MOSS-TTS系列负责语音合成(让AI"说话",还能拟声、生成音效),其中MOSS-TTSD是国内首个基于百万小时音频训练的开源中英双语对话语音模型。MOSS-VL负责视觉理解,让 AI"看懂" 画面。MOSS Live是公司把众多单点能力接成的一套实时交互系统,由"前端交互模型"和"后端能动性模型"协同工作,前者持续看、听、说,后者负责复杂推理和任务执行。

简单点说,模思智能不是卖一个聊天软件,而是提供"让AI看懂、听懂、说好、并且能在真实环境里持续和人打交道"这一整套底层模型能力。
三大核心技术
模思智能的核心技术可以用三条主线来理解,第一是从语音切入的离散化端到端路线,就是把连续的声音信号拆解、映射成一串串离散的Token(相当于给声音编成数字码),让语音和文本进入同一个计算空间。第二是全模态统一Token架构。,在离散化语音的基础上,模思智能把语音、文本、图像、视频统一映射到同一套Token序列结构里进行理解和生成,不同模态不再割裂、分别训练。
第三是实时交互与"AI for AI"的系统能力,让AI跟上一个不断变化的现场——用户说一半改口、新画面进来改变前一句话含义、设备和环境始终在变。同时,公司大力推进"AI for AI":用AI生成模型生产新的语音、图像、视频、场景数据,用理解模型判断、筛选、反馈,把结果送回下一轮训练,让模型迭代更多由AI之间协同完成,减少人工依赖。
多场景展开合作
过去几年,开源智能底座逐渐成熟、全模态推理成本持续下降、AI眼镜和AI玩具等硬件开始进入市场,模型、成本和入口三方面同时变化,让"AI进入现实世界"从想象变成具体的工程问题。这正是模思押注的增量市场所在。模思智能已在消费电子、智能汽车、具身智能与AI陪伴等多个场景与头部客户展开合作。
作为国内全模态实时交互智能赛道极具代表性的初创企业,尽管成立时间很短,但在技术布局、团队密度、资本认可度方面,它已是这一波"情境智能"浪潮中最值得关注的中国公司之一。





热门跟贴