


据投融湾获悉,近日,杭州深度求索人工智能基础技术研究有限公司(下文简称:DeepSeek)成功完成了约1000亿元人民币(约150亿美元)的A+轮融资,这也是中国有史以来规模最大的融资之一。本轮融资的投资者包括宁德时代、腾讯、石溪资本、中芯聚源、CPE源峰、君联资本、吉利控股集团、IDG资本、Monolith砺思资本、拾象科技。特别值得一提的是,在2026年6月,DeepSeek刚完成约510亿元的A轮融资。
DeepSeek创立于2023年7月,公司总部位于浙江省杭州市拱墅区。DeepSeek的核心定位是一家通用人工智能(AGI)基础模型研发商,专注于研究世界领先的大语言模型和相关底层技术。
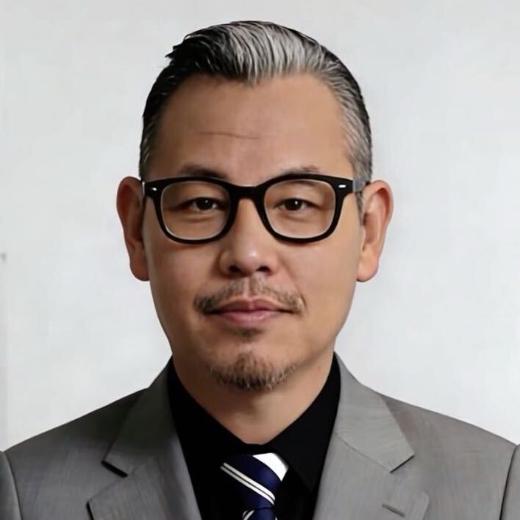
创始人梁文锋
DeepSeek的创始人是梁文锋,17岁以吴川一中高考状元的身份考入浙江大学电子信息工程专业。本科毕业后继续在浙大深造,2010年获得信息与通信工程硕士学位。2013年,梁文锋与浙大同学徐进共同创立杭州雅克比投资管理有限公司,正式进入量化投资领域。2015年,他又创立杭州幻方科技有限公司(即幻方量化)。2023年,创立DeepSeek。特别值得一提的是,大疆创始人汪滔曾邀请梁文锋一起创业,但他选择了继续走自己的路。
大语言模型
我们平时用的AI背后都有一个大语言模型,DeepSeek做的就是这种模型,而且它把模型免费开源给全世界用。那到底什么是大语言模型呢?其实很简单,它就像是一个什么都知道的学霸,无论问它什么,它都能做出回答。你让它写文章,算题,它都能完成。

最省钱、最聪明
DeepSeek最出名的不是"参数最多",而是"最省钱、最聪明"。能做到这一点,主要靠的就是三个技术创新。MoE(混合专家模型),把模型拆成很多个"专家小组",每次只调用最相关的几个专家来回答问题,这样又省算力又快。
MLA(多头潜在注意力),这是一种让模型"记忆"更高效的技术,能把记忆压缩成更紧凑的形式,让模型在处理超长文本时既省内存又不失精度。FP8混合精度训练,把计算精度降到更低,但通过巧妙的混合方案,效果几乎不损失,却能省一半以上的显存和算力。
万亿级市场
DeepSeek所处的赛道是全球AI大模型产业,这是一个正在爆发式增长的万亿级市场。据推算,2026年,全球企业在AI模型及平台上的支出将达到640亿美元,比2025年的390亿美元增长63.4%。中国市场方面,据测算,2025年,中国人工智能核心产业规模已超过1.2万亿元人民币。
DeepSeek是中国AI大模型领域最具全球影响力的公司之一,它证明了"少花钱也能做出顶级模型",它用开源策略重塑了行业生态。DeepSeek已经从一个"低成本黑马"成长为全球AI格局中不可忽视的一极,它的技术实力、开源策略和工程效率都经过了全球市场的验证。





热门跟贴